01
데이터셋
목표로 하는 화풍·캐릭터에 맞춰 이미지를 고르고 정리합니다. 적은 장수로 학습하는 만큼 무엇을 넣고 뺄지가 결과를 좌우합니다.

AI Art 워크플로우에 최적화된 개발자
About
이미지 모델을 직접 학습시키고, 그 모델이 실제 제작 과정에서 쓰이도록 도구와 파이프라인을 만듭니다. 그림을 만드는 쪽과 서비스를 만드는 쪽을 모두 해 본 경험으로, 아티스트가 실제로 막히는 지점을 기능으로 풀어 왔습니다.
로컬 모델(LoRA) 학습에서 시작해, 이미지·영상·3D 생성 모델을 한곳에 모은 통합 AI 아트 포털 웹을 개발했습니다. 수십 개의 생성 API를 하나의 작업 흐름으로 묶는 일과, 3D 포즈 에디터나 모션 비디오 편집기처럼 브라우저에서 직접 돌아가는 제작 도구를 만드는 일을 함께 했습니다.
01 — Local Model · LoRA
필요한 화풍과 캐릭터를 얻기 위해 데이터셋을 직접 구성하고, 로컬 환경에서 LoRA를 학습해 이미지 모델을 만들어 왔습니다. 베이스 모델이 바뀔 때마다 학습 방식을 다시 맞추며 여러 세대의 모델을 다뤘습니다.


01
목표로 하는 화풍·캐릭터에 맞춰 이미지를 고르고 정리합니다. 적은 장수로 학습하는 만큼 무엇을 넣고 뺄지가 결과를 좌우합니다.
02
로컬 환경에서 LoRA를 학습합니다. 베이스 모델마다 구조와 적정 설정이 달라, 세대가 바뀔 때마다 학습 방식을 다시 맞춥니다.
03
학습한 모델을 실제 생성 워크플로우에 넣어 보고, 다른 LoRA·ControlNet과 함께 썼을 때도 의도한 결과가 나오는지 확인합니다.
02 — AI Art Portal
이미지·영상·3D 생성 모델을 한곳에 모은 통합 AI 아트 포털 웹을 개발했습니다. 여러 공급자의 모델을 하나의 화면과 하나의 작업 흐름으로 묶어, 한 단계의 결과물이 다음 단계의 입력으로 바로 넘어가도록 설계했습니다. 이미지로 만든 결과가 영상이 되고, 3D 모델이 되고, 리깅과 애니메이션까지 이어집니다.
A
생성부터 편집·보정까지 한 화면에서 이어지는 이미지 파이프라인.
B
완성된 이미지를 그대로 받아 움직임을 입히는 영상 파이프라인.
C
이미지 한 장에서 게임에 쓸 수 있는 모델까지 가는 3D 파이프라인.
Image Video / Image Prop 3D 3D Rig Animation
03 — 3D Pose to Image
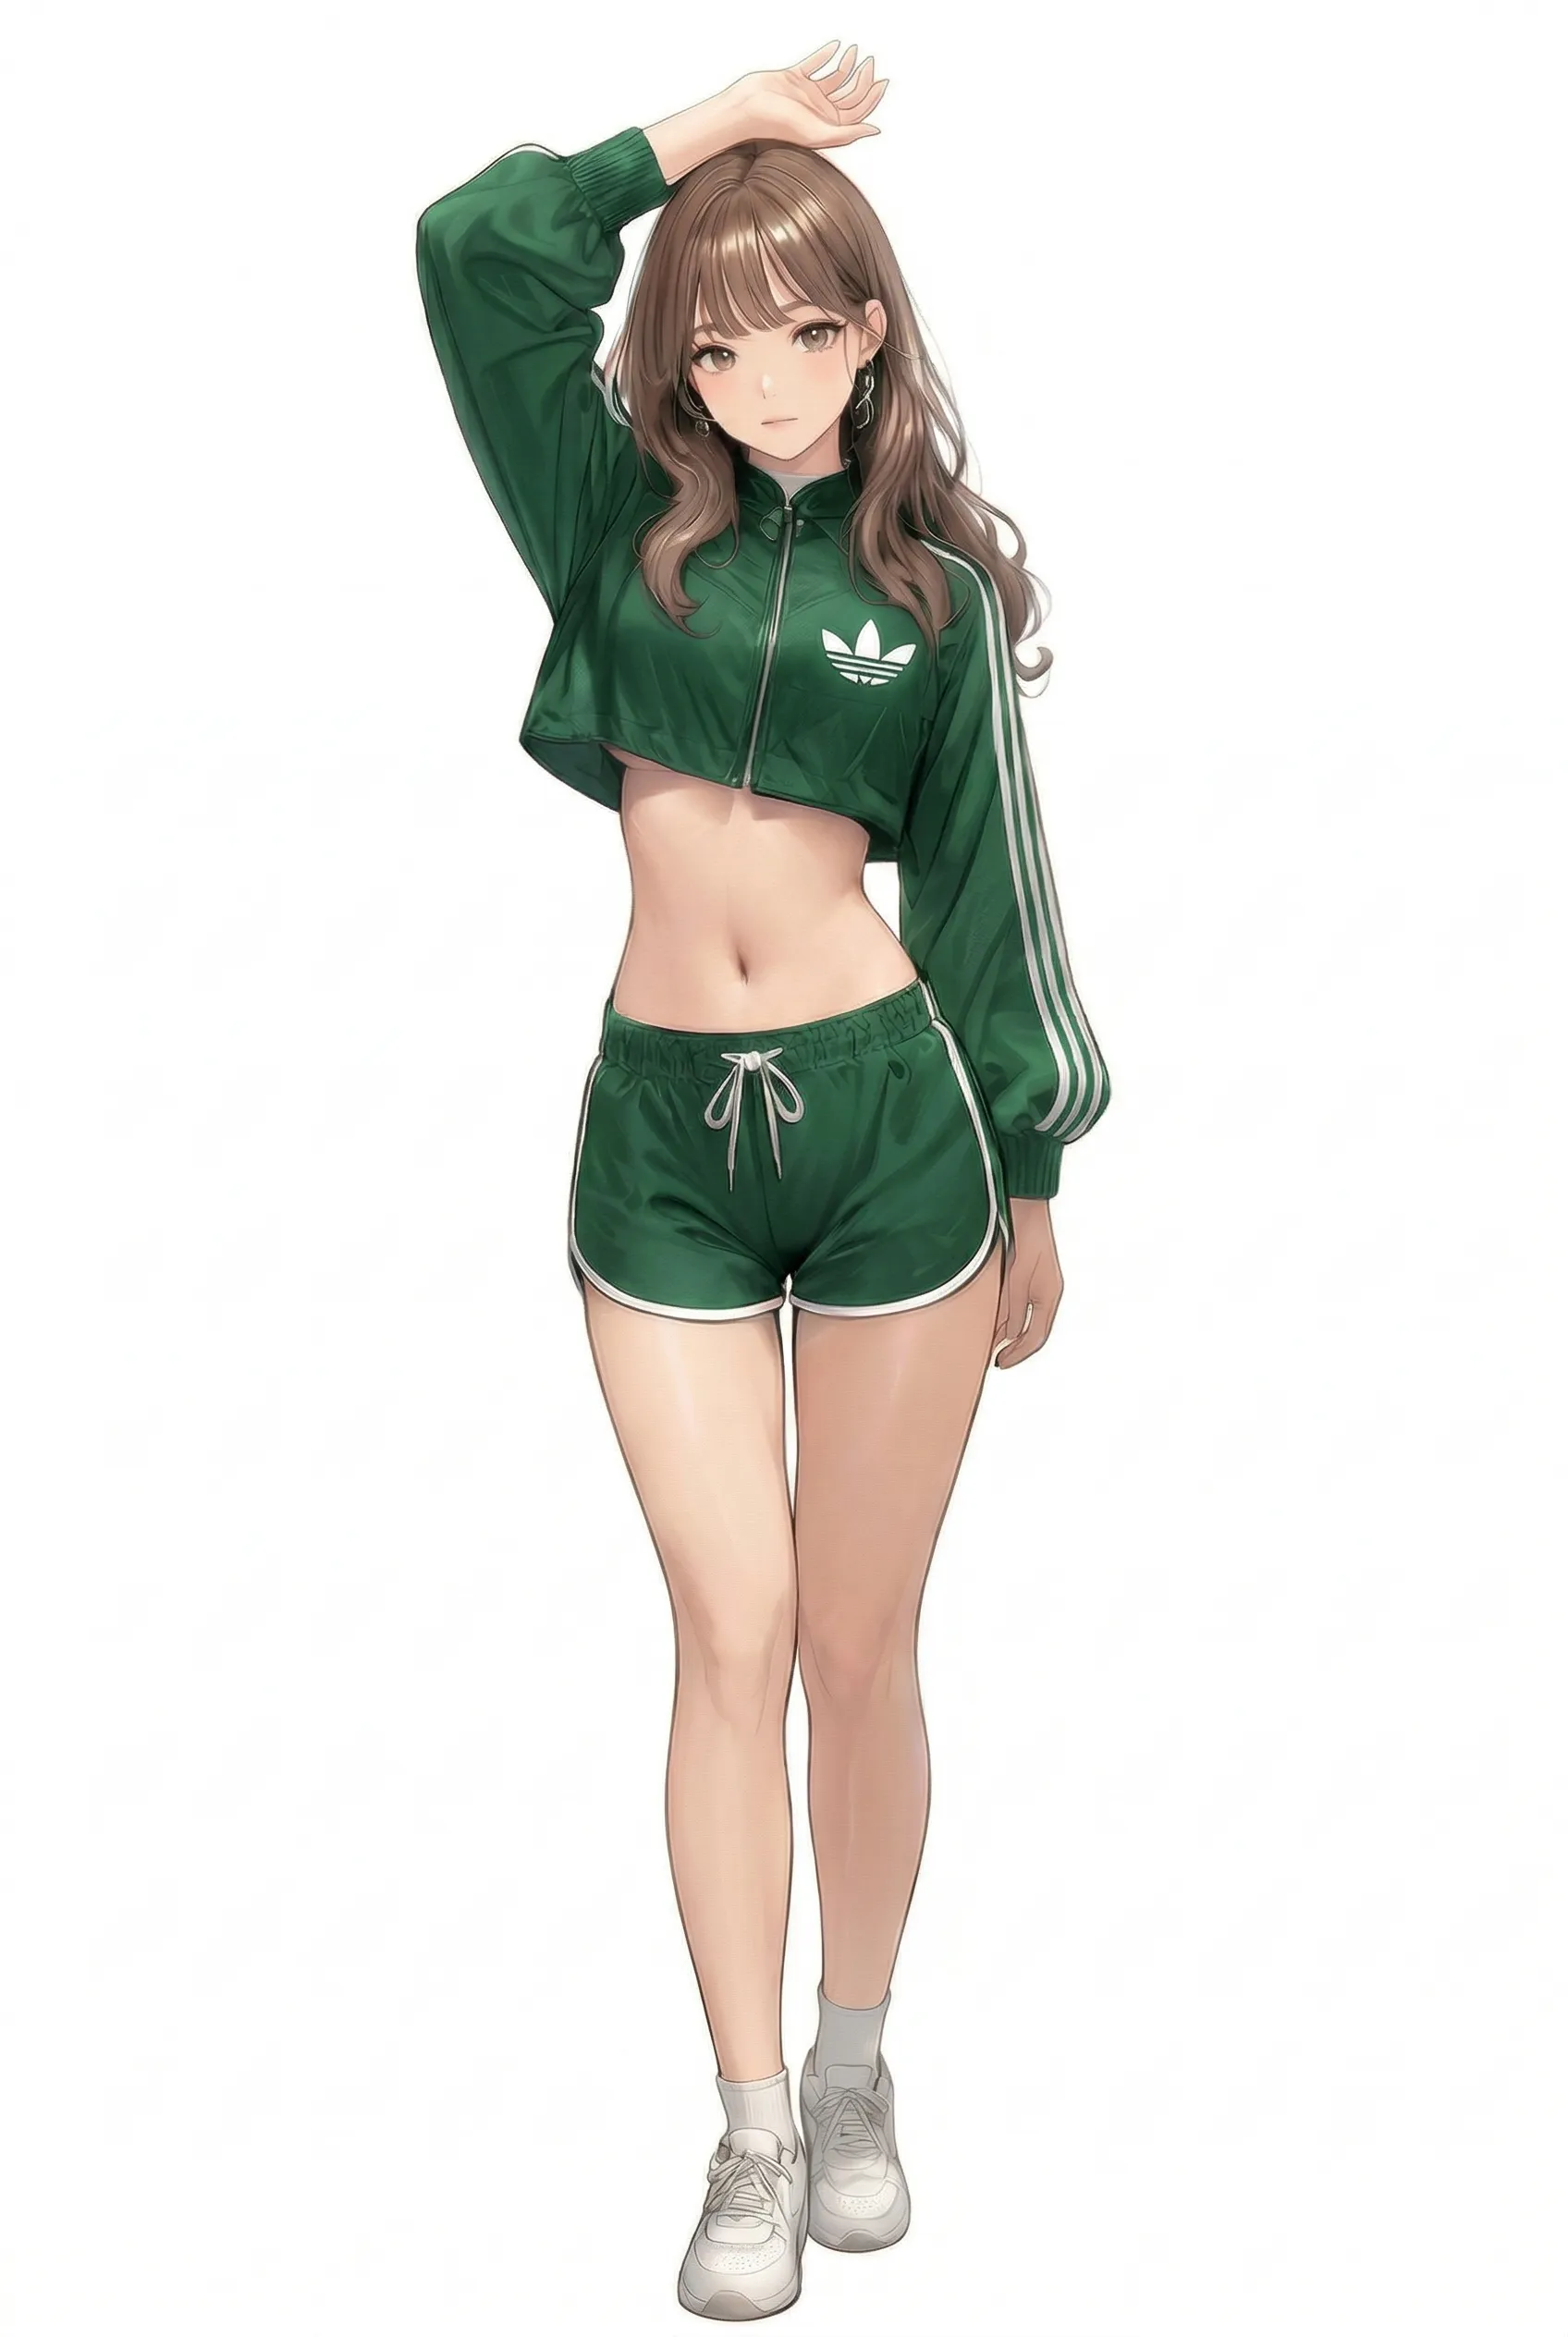
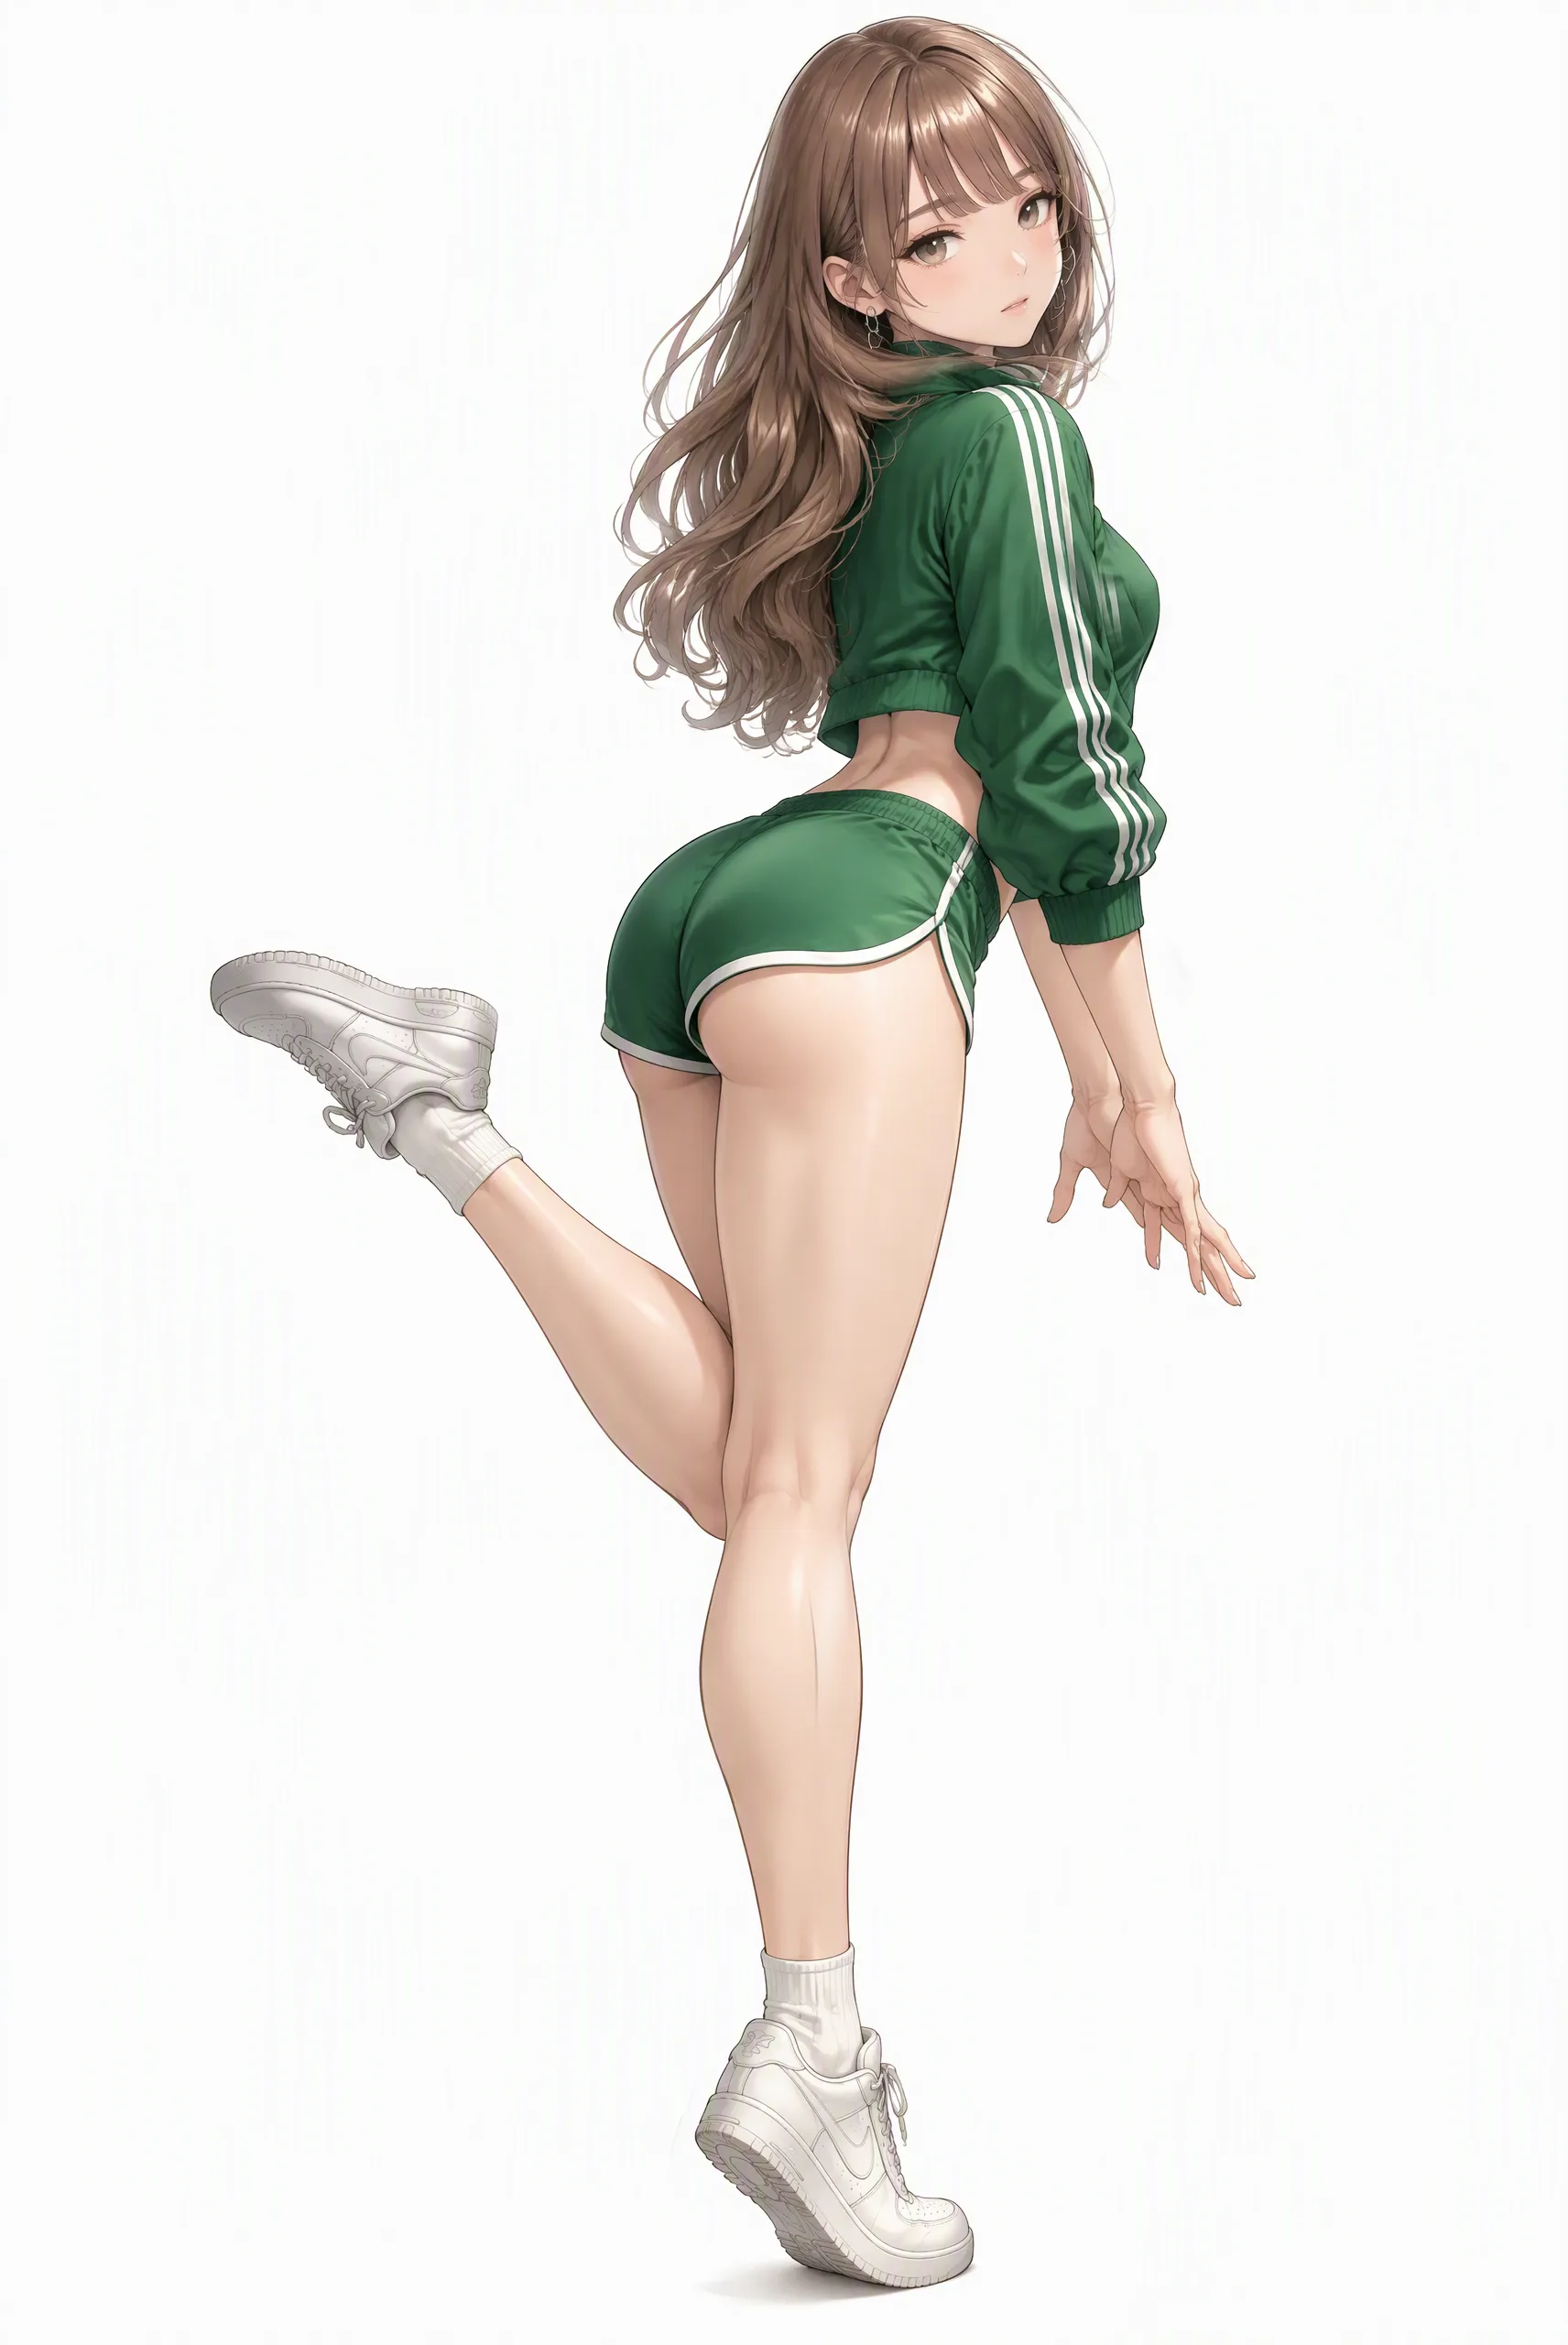
프롬프트만으로는 원하는 포즈를 정확히 얻기 어렵습니다. 3D 마네킹으로 포즈를 직접 잡고, 그 화면을 참조로 넘겨 캐릭터에 같은 포즈를 입히는 도구를 만들었습니다. 포즈를 말로 설명하는 대신 눈으로 보고 맞춥니다.
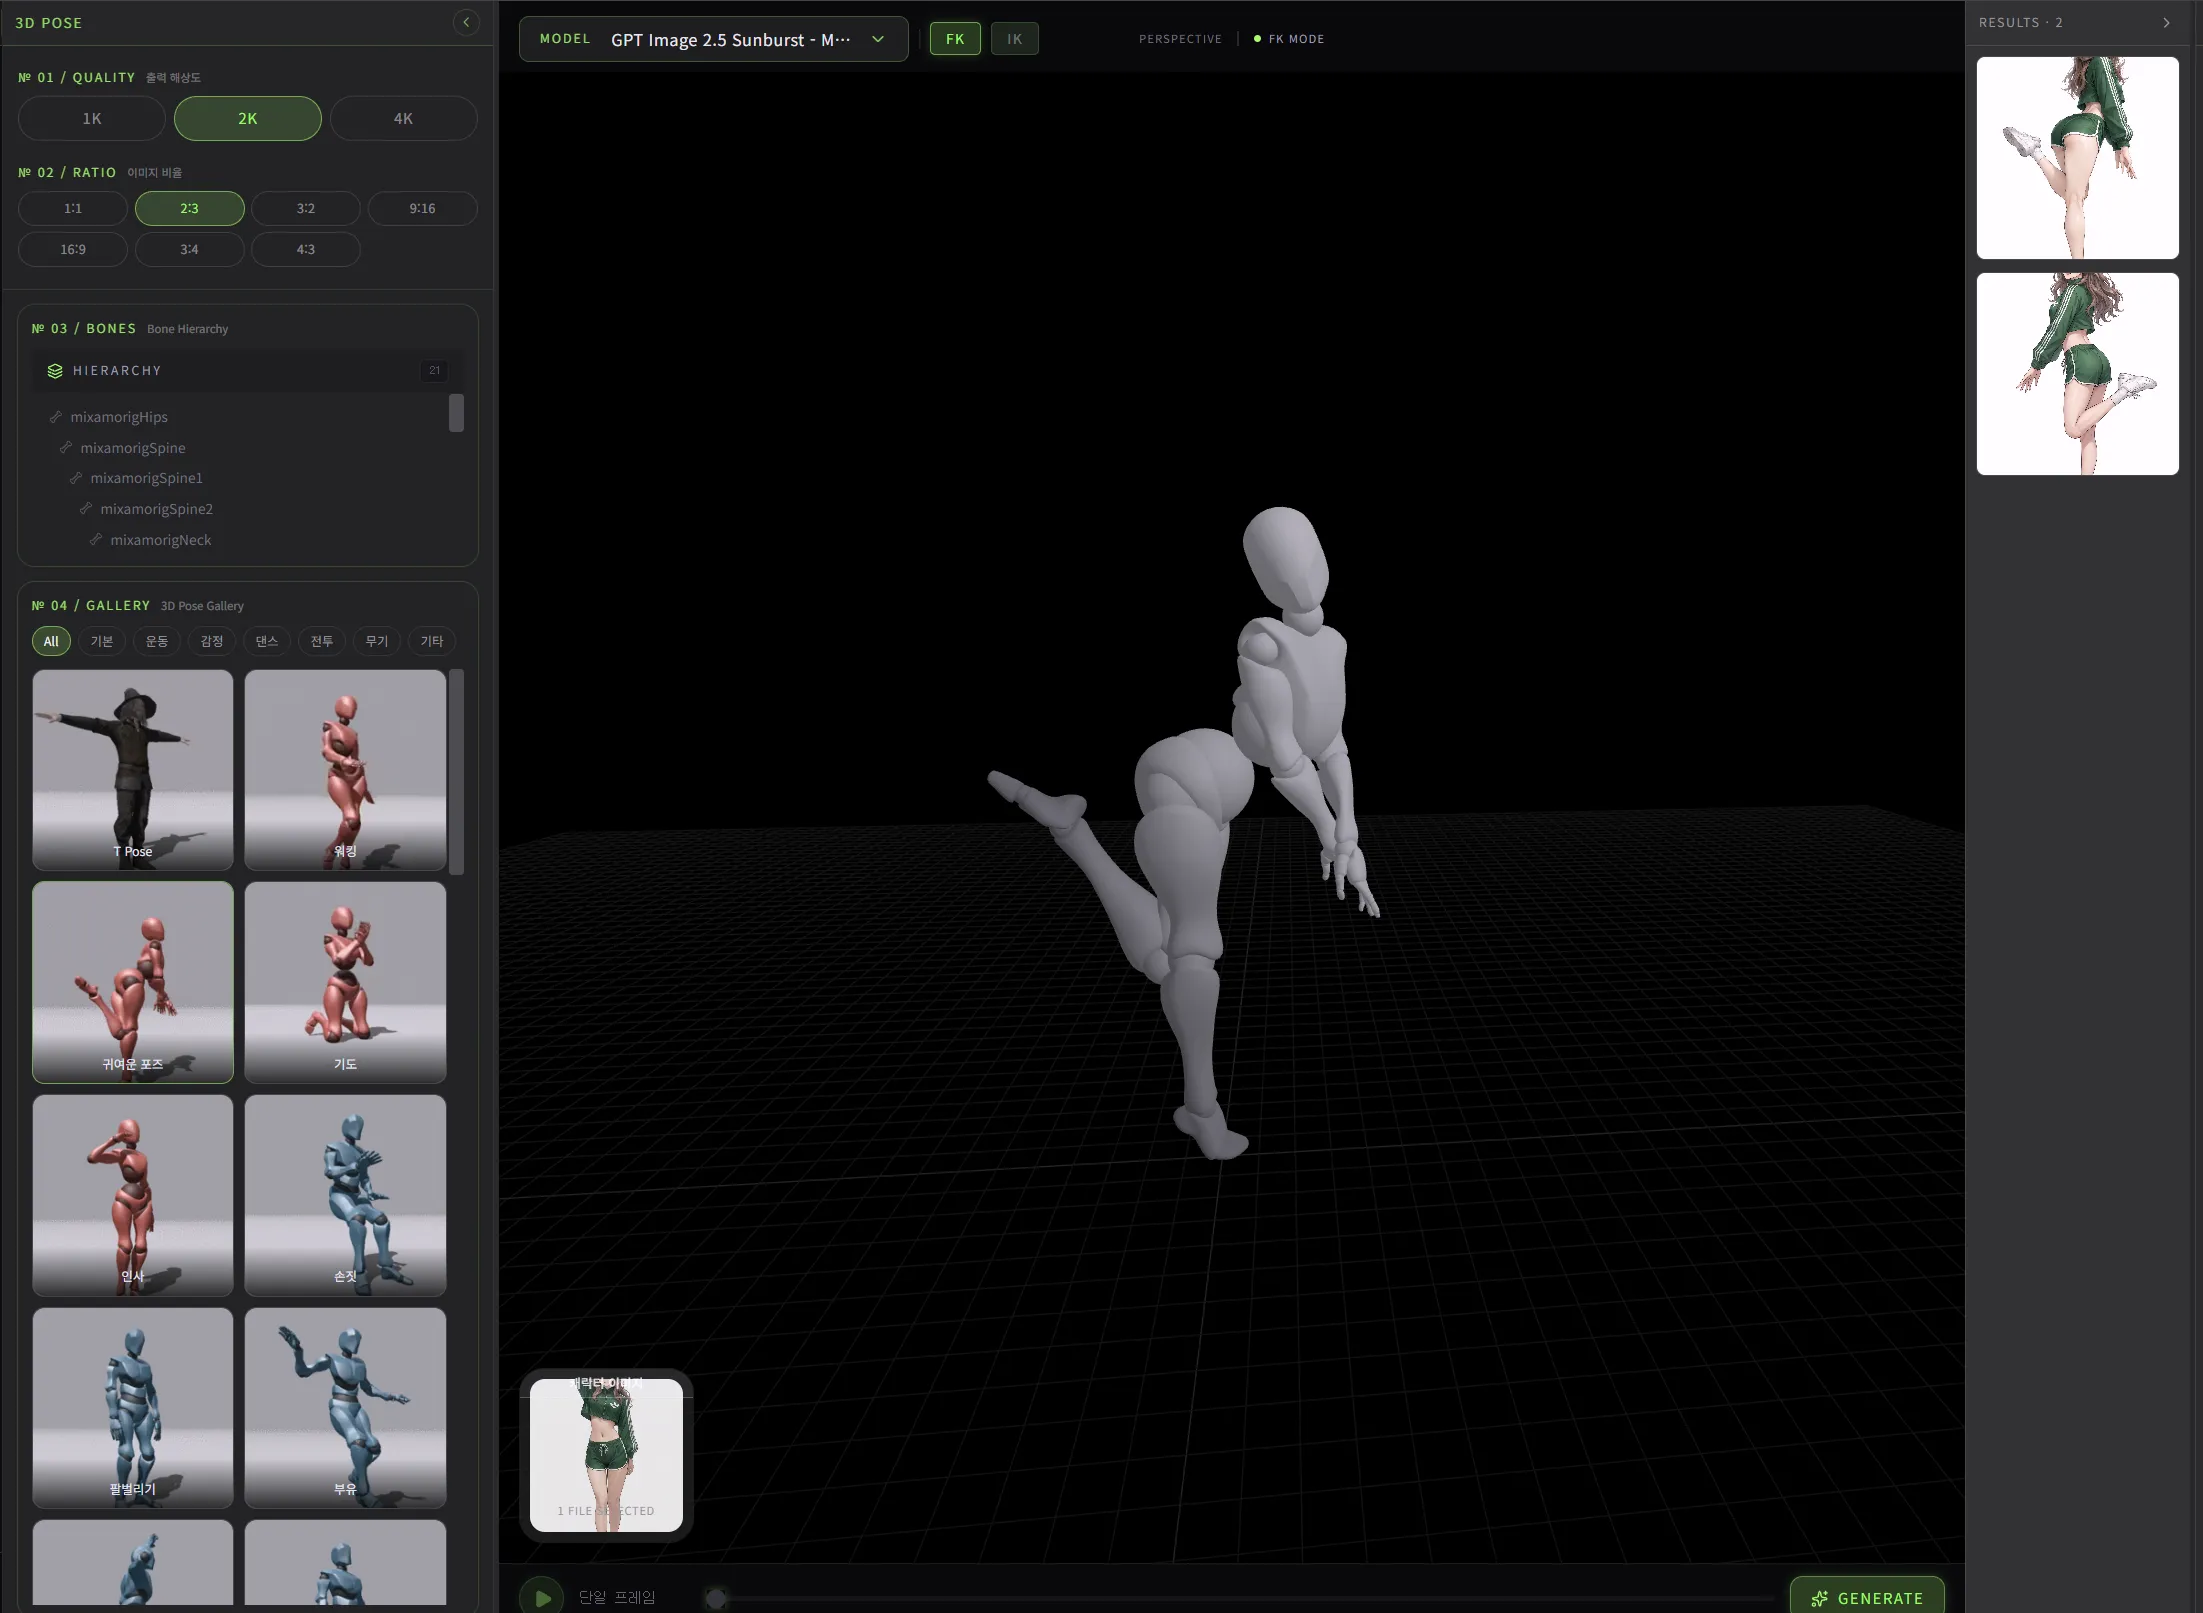
three.js로 만든 편집 화면입니다. 스킨이 입혀진 기본 리그를 불러와 회전·이동 기즈모로 조작하고, 본 목록이나 화면의 본 핸들을 눌러 관절을 고릅니다. 사용자가 가진 FBX를 끌어다 넣어 쓸 수도 있습니다.
FK 모드에서는 선택한 본을 로컬 축으로 회전합니다. IK 모드에서는 손·발의 타깃 핸들을 옮기면 직접 구현한 CCD 솔버가 관절 체인을 풀어 줍니다. 체인은 부모 본을 따라 자동으로 구성하고 척추·골반에서 멈춥니다.
기본·운동·감정·댄스·전투·무기·기타 7개 분류에 38개 프리셋을 넣었습니다. 모션 클립은 재생하다가 원하는 프레임에서 멈춰 그 순간을 포즈로 씁니다.
생성을 누르면 그리드와 본 핸들을 숨기고 카메라를 모델에 맞춘 뒤 화면을 저장합니다. 캐릭터 이미지를 입력으로, 포즈 화면을 참조로 함께 보내 이미지 편집 모델이 포즈를 옮겨 그립니다. 출력 해상도(1K·2K·4K)와 비율을 고를 수 있습니다.
04 — Prop 3D
이미지 한 장을 그대로 3D로 변환하면 배경, 조명, 가려진 부분 때문에 결과가 무너집니다. 3D로 만들 대상만 골라 변환에 적합한 이미지로 다시 그려 주는 전처리 단계를 만들었습니다.
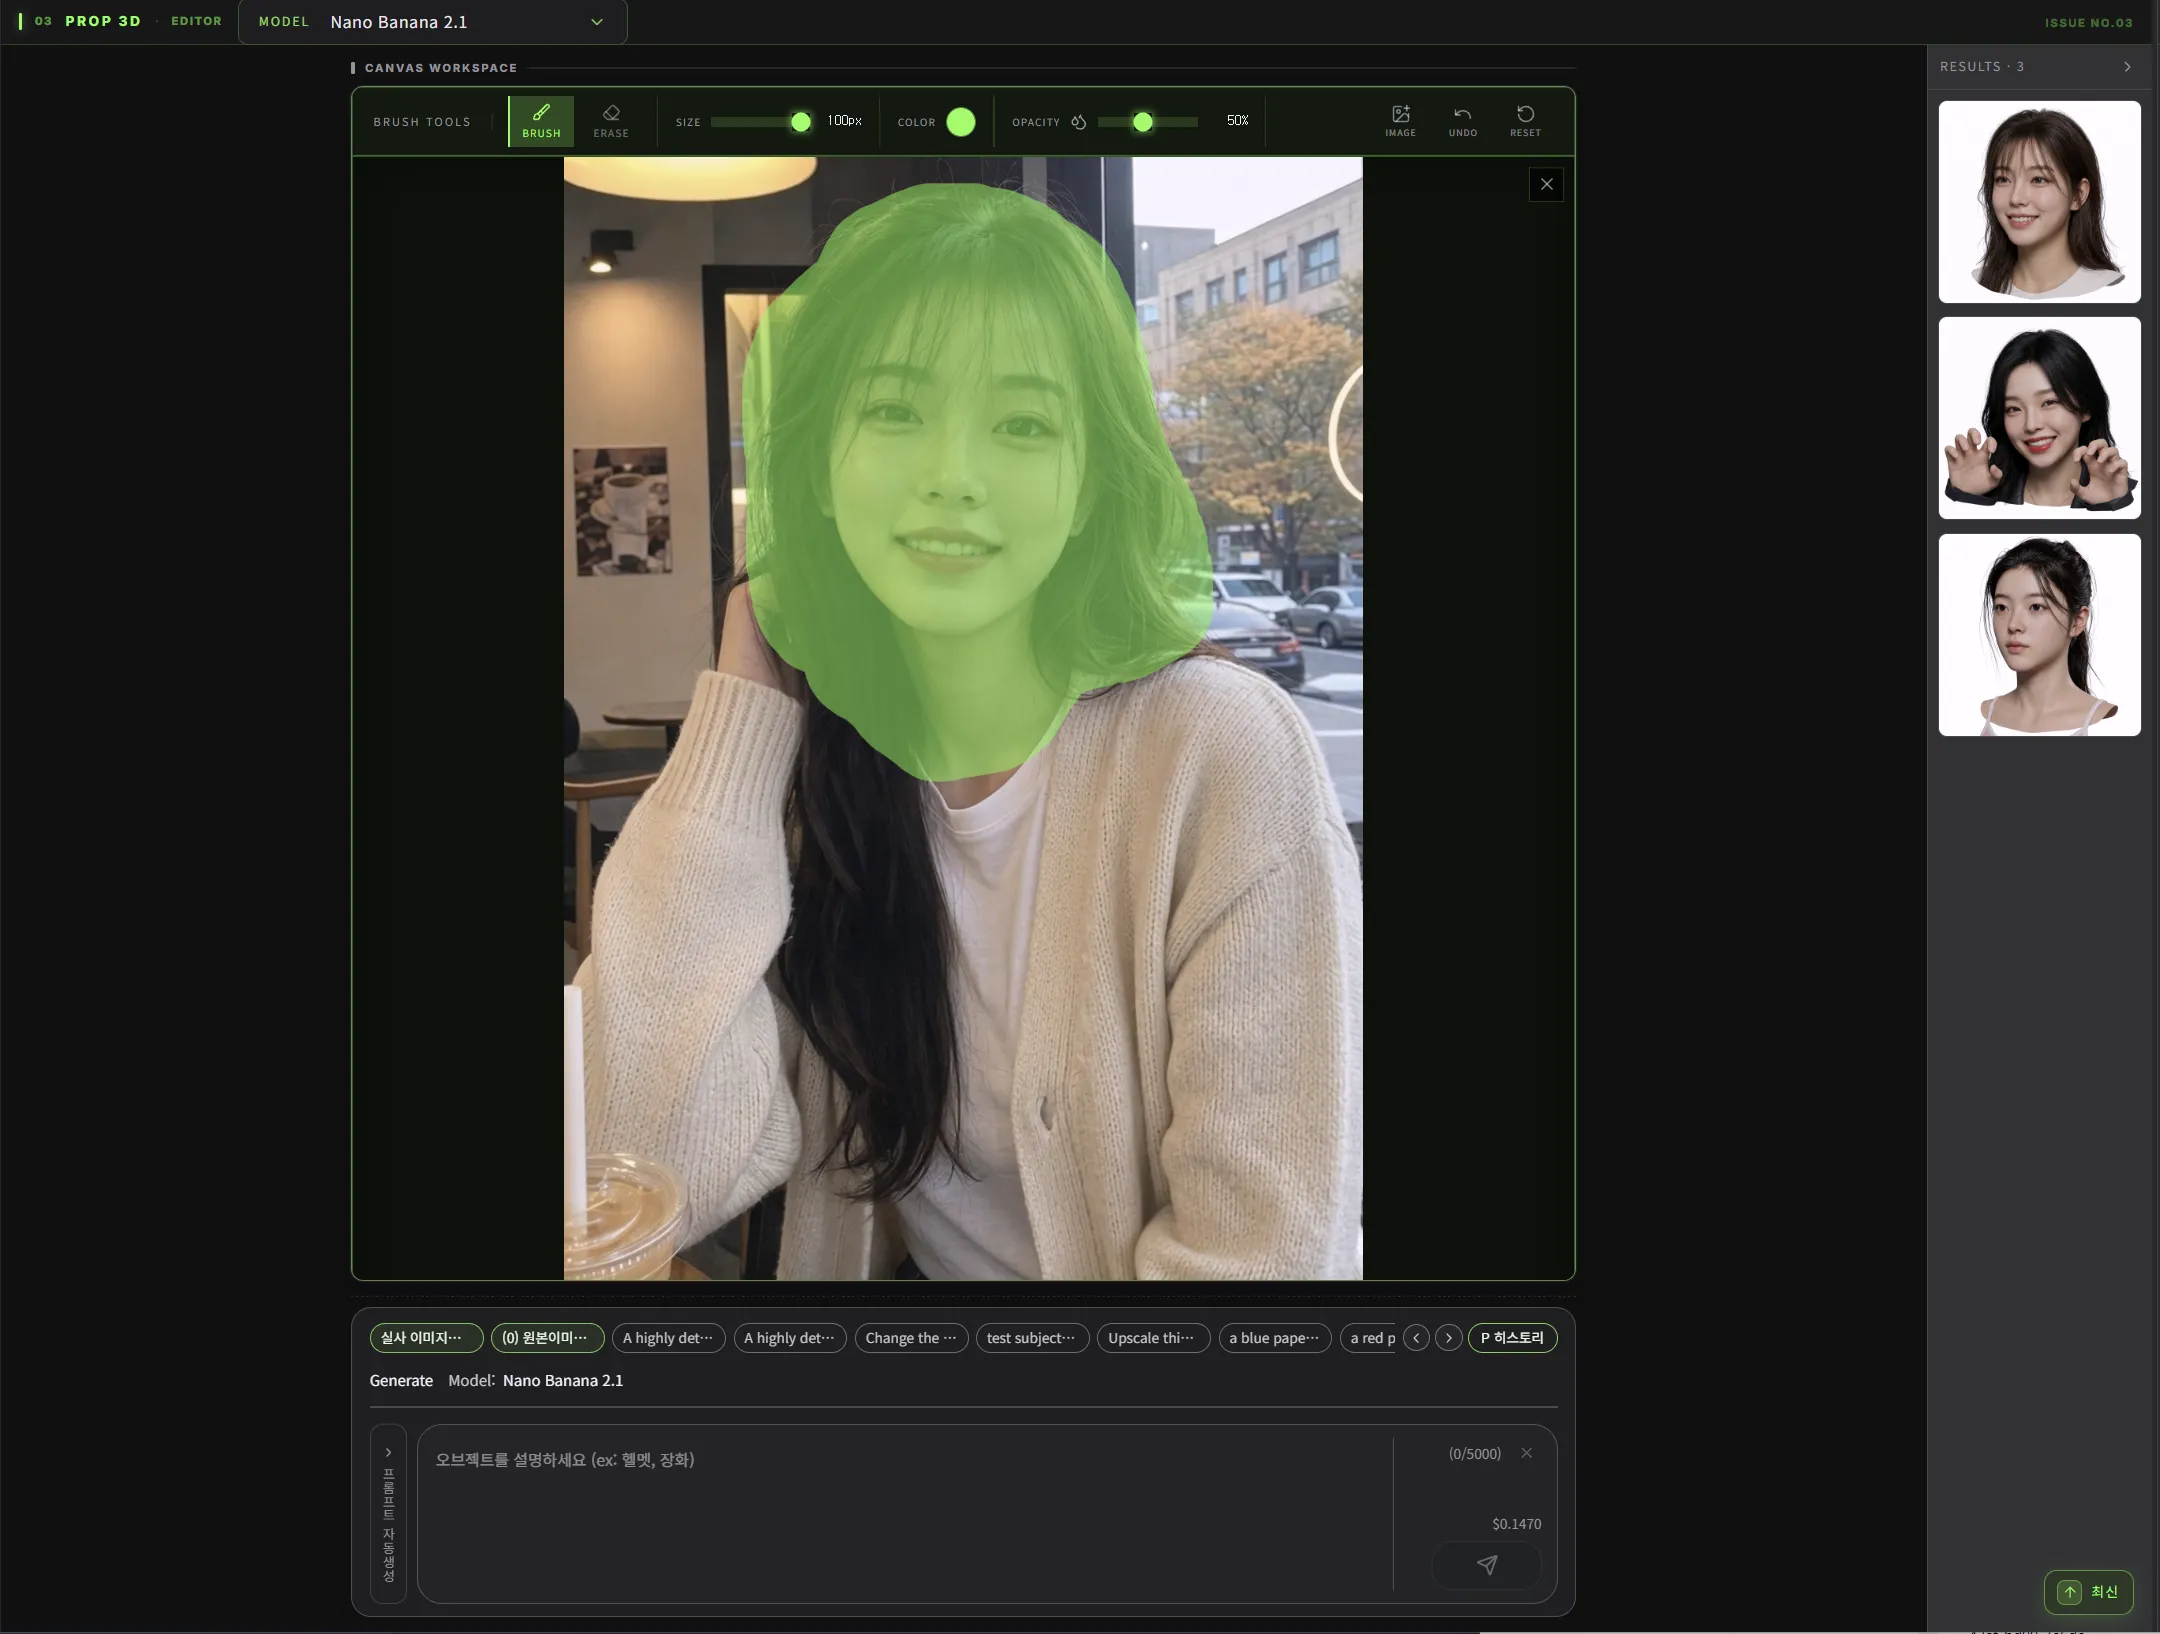
원본 위에 브러시로 3D로 만들 부분을 칠합니다. 칠한 영역을 감싸는 범위만 잘라 모델 입력으로 쓰므로, 복잡한 사진에서도 원하는 대상만 다룰 수 있습니다. 확대·이동·되돌리기를 지원합니다.
잘라낸 영역을 비전 모델에 보내 형태와 재질을 설명하는 문장을 받아 프롬프트 칸에 채워 줍니다. 사용자는 필요한 부분만 고치면 됩니다.
서버가 프롬프트에 규칙을 덧붙입니다. 흰색 또는 투명 배경에 대상만 분리하고, 그림자 없는 중립 조명과 선명한 윤곽, 약 45도 아이소메트릭 시점으로 그리게 해 3D 생성 모델이 형태를 읽기 쉽게 만듭니다.
결과 카드의 버튼 한 번으로 3D 생성 워크플로우에 넘깁니다. 이후 로우폴리 변환, 리텍스처, 리깅까지 같은 화면 흐름에서 이어집니다.
05 — Image to Motion Video
배경 일러스트에 구름이 흐르고 등불이 깜빡이는 정도의 움직임에는 영상 생성 모델이 필요 없습니다. 브라우저만으로 루프 영상을 만드는 편집 도구를 만들었습니다. 생성 API를 호출하지 않고 서버 GPU도 쓰지 않아, 비용 없이 몇 번이든 다시 만들 수 있습니다.
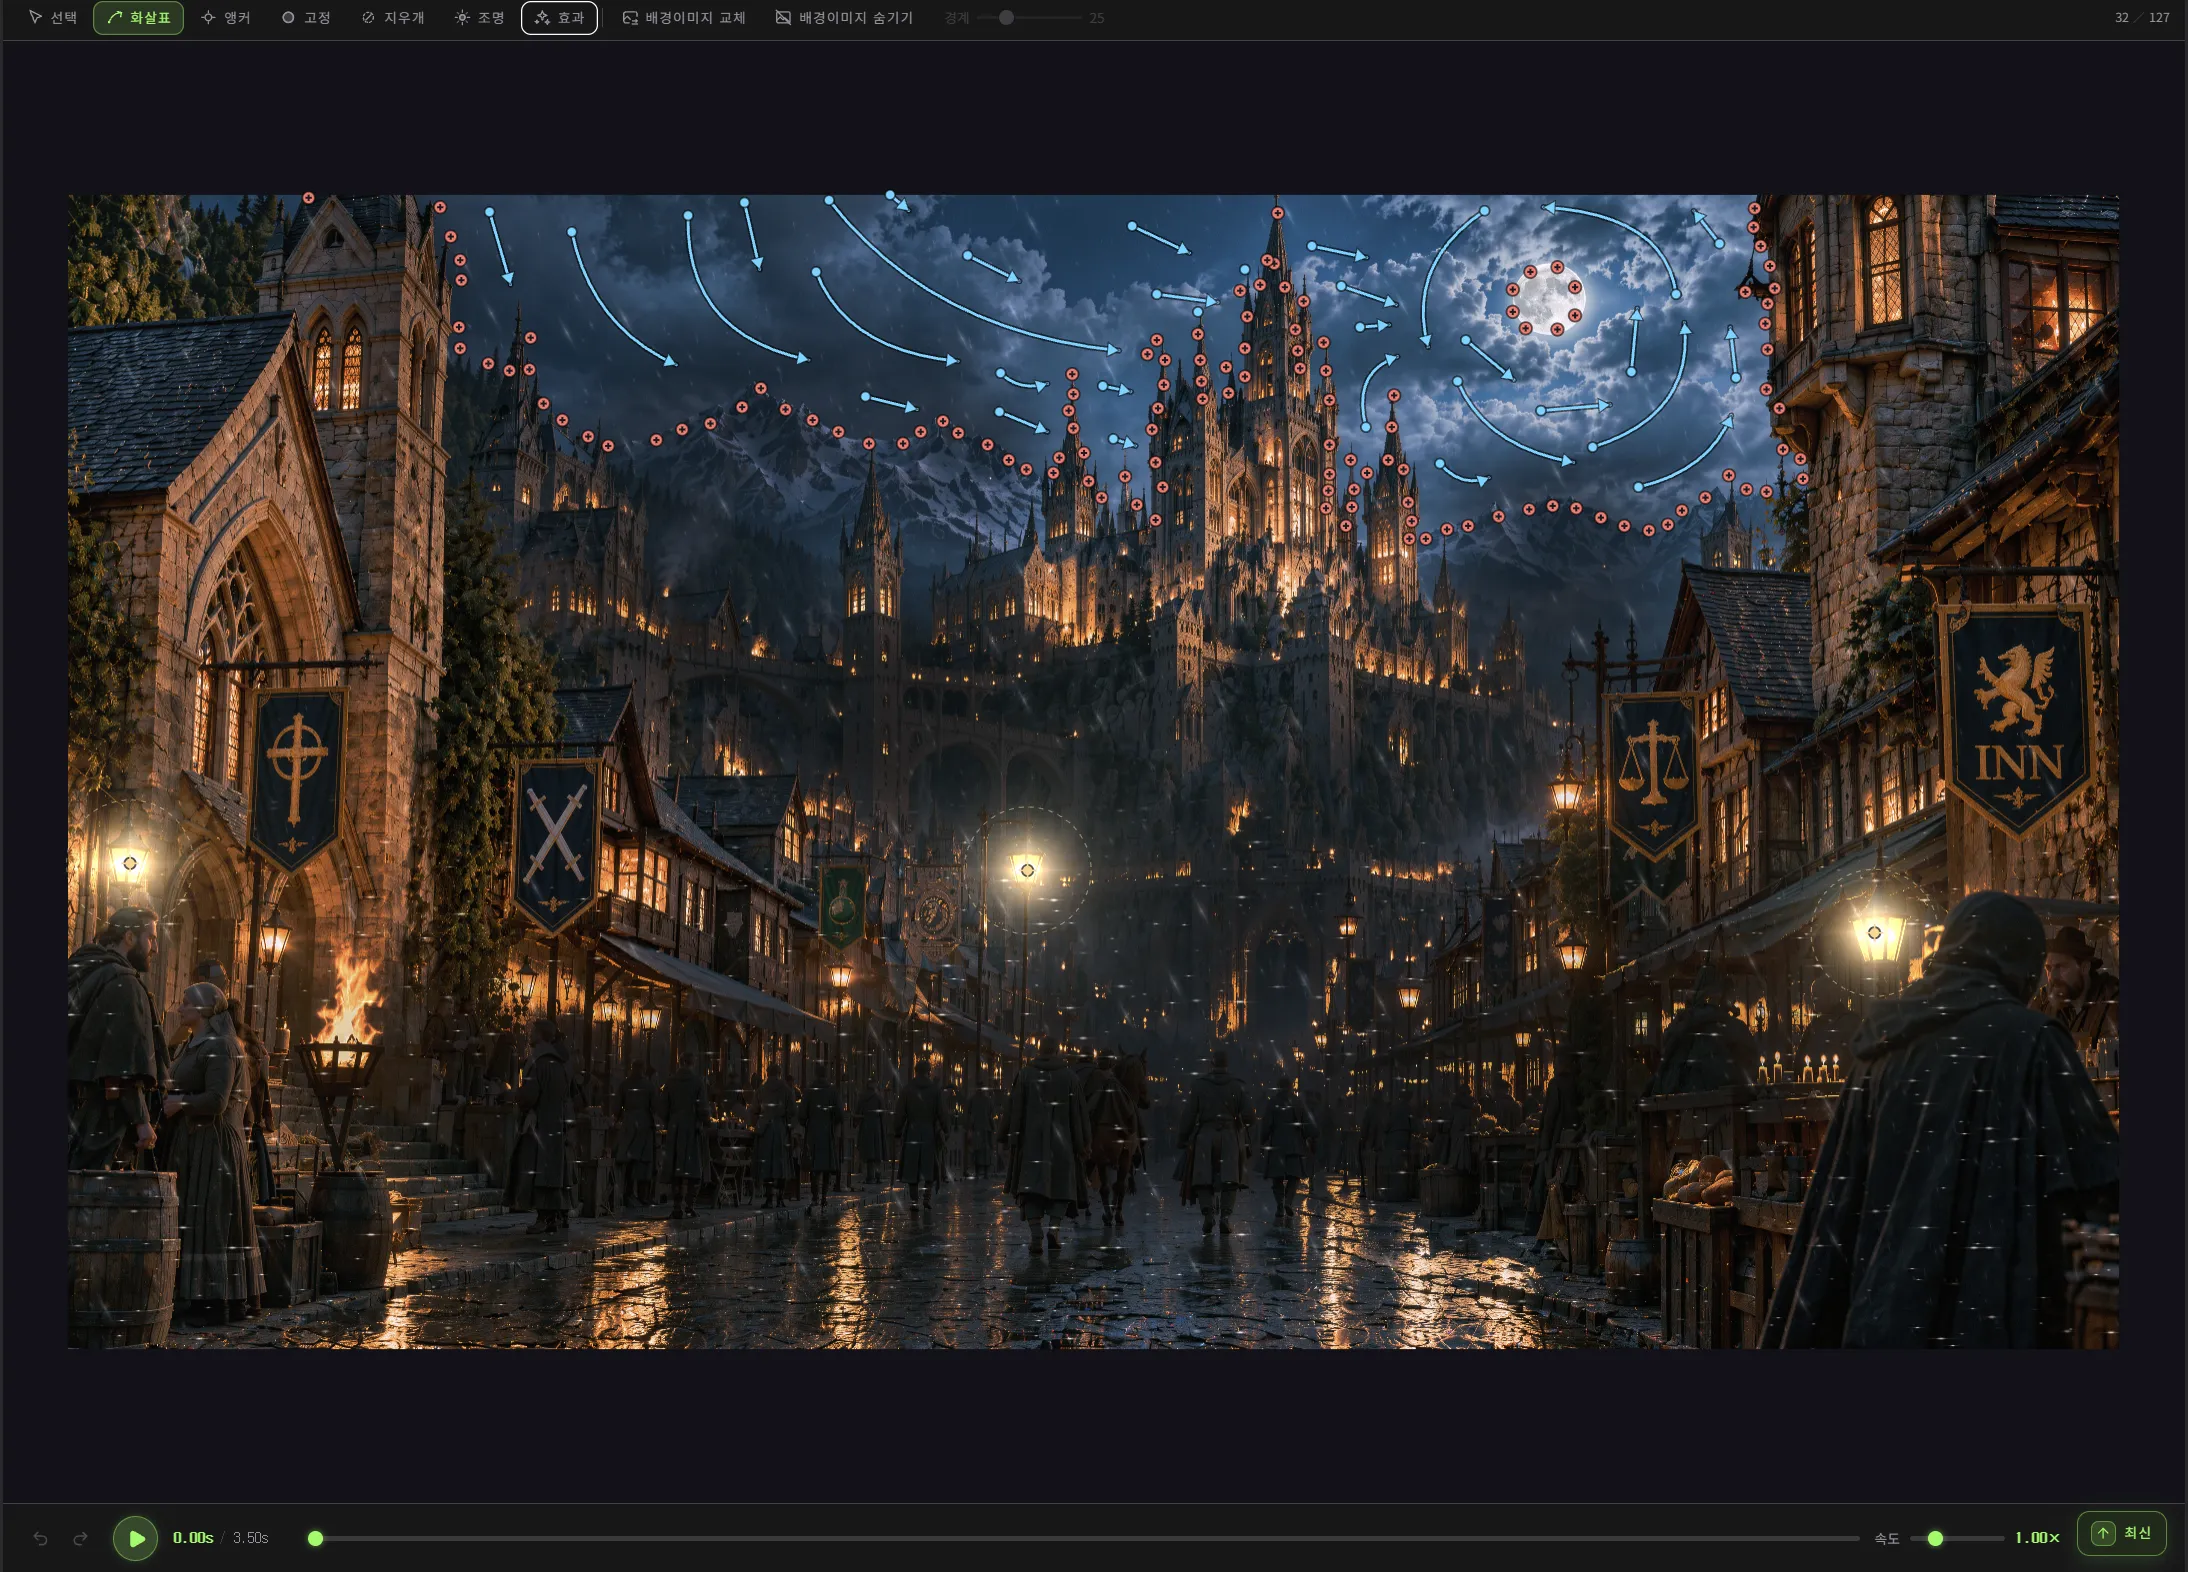
화살표로 흐름의 방향과 속도를 그리고(곡선 가능), 앵커와 고정 브러시로 움직이면 안 되는 곳을 잡습니다. 조명 핀은 등불처럼 깜빡이는 빛을 얹습니다.
화살표·앵커·마스크를 경계 조건으로 삼아 화면 전체의 흐름을 WebGL2 셰이더에서 계산합니다. 해상도 피라미드 위에서 반복 계산으로 흐름을 퍼뜨리고, 이미지를 그 흐름대로 변형합니다.
위상이 어긋난 두 변형을 교차로 섞어 끝과 처음이 자연스럽게 이어지게 했습니다. 입자 효과는 루프 길이에 정수 번 반복되도록 맞춥니다.
비, 눈, 안개, 오로라, 물결 반사 등 22종 효과를 겹쳐 올릴 수 있습니다. 대부분 절차적 셰이더로 그려 해상도에 구애받지 않습니다.
한 루프를 프레임으로 렌더링한 뒤 ffmpeg.wasm으로 인코딩합니다. MP4, GIF, WebM, 움직이는 WebP로 내보내고, 12~60fps와 1080p·세로·정사각 프리셋, 투명 배경(WebM·WebP)을 지원합니다.
작업 내용은 브라우저 저장소에 자동으로 저장되어, 나중에 다시 열어 이어서 고칠 수 있습니다.
06 — Midjourney Workflow
미드저니를 포털의 다른 모델과 같은 방식으로 쓸 수 있게 API로 연동했습니다. 별도 서비스를 오가지 않고 같은 화면, 같은 작업 큐, 같은 히스토리에서 다루고, 결과를 곧바로 편집·영상·3D 워크플로우로 넘길 수 있습니다.
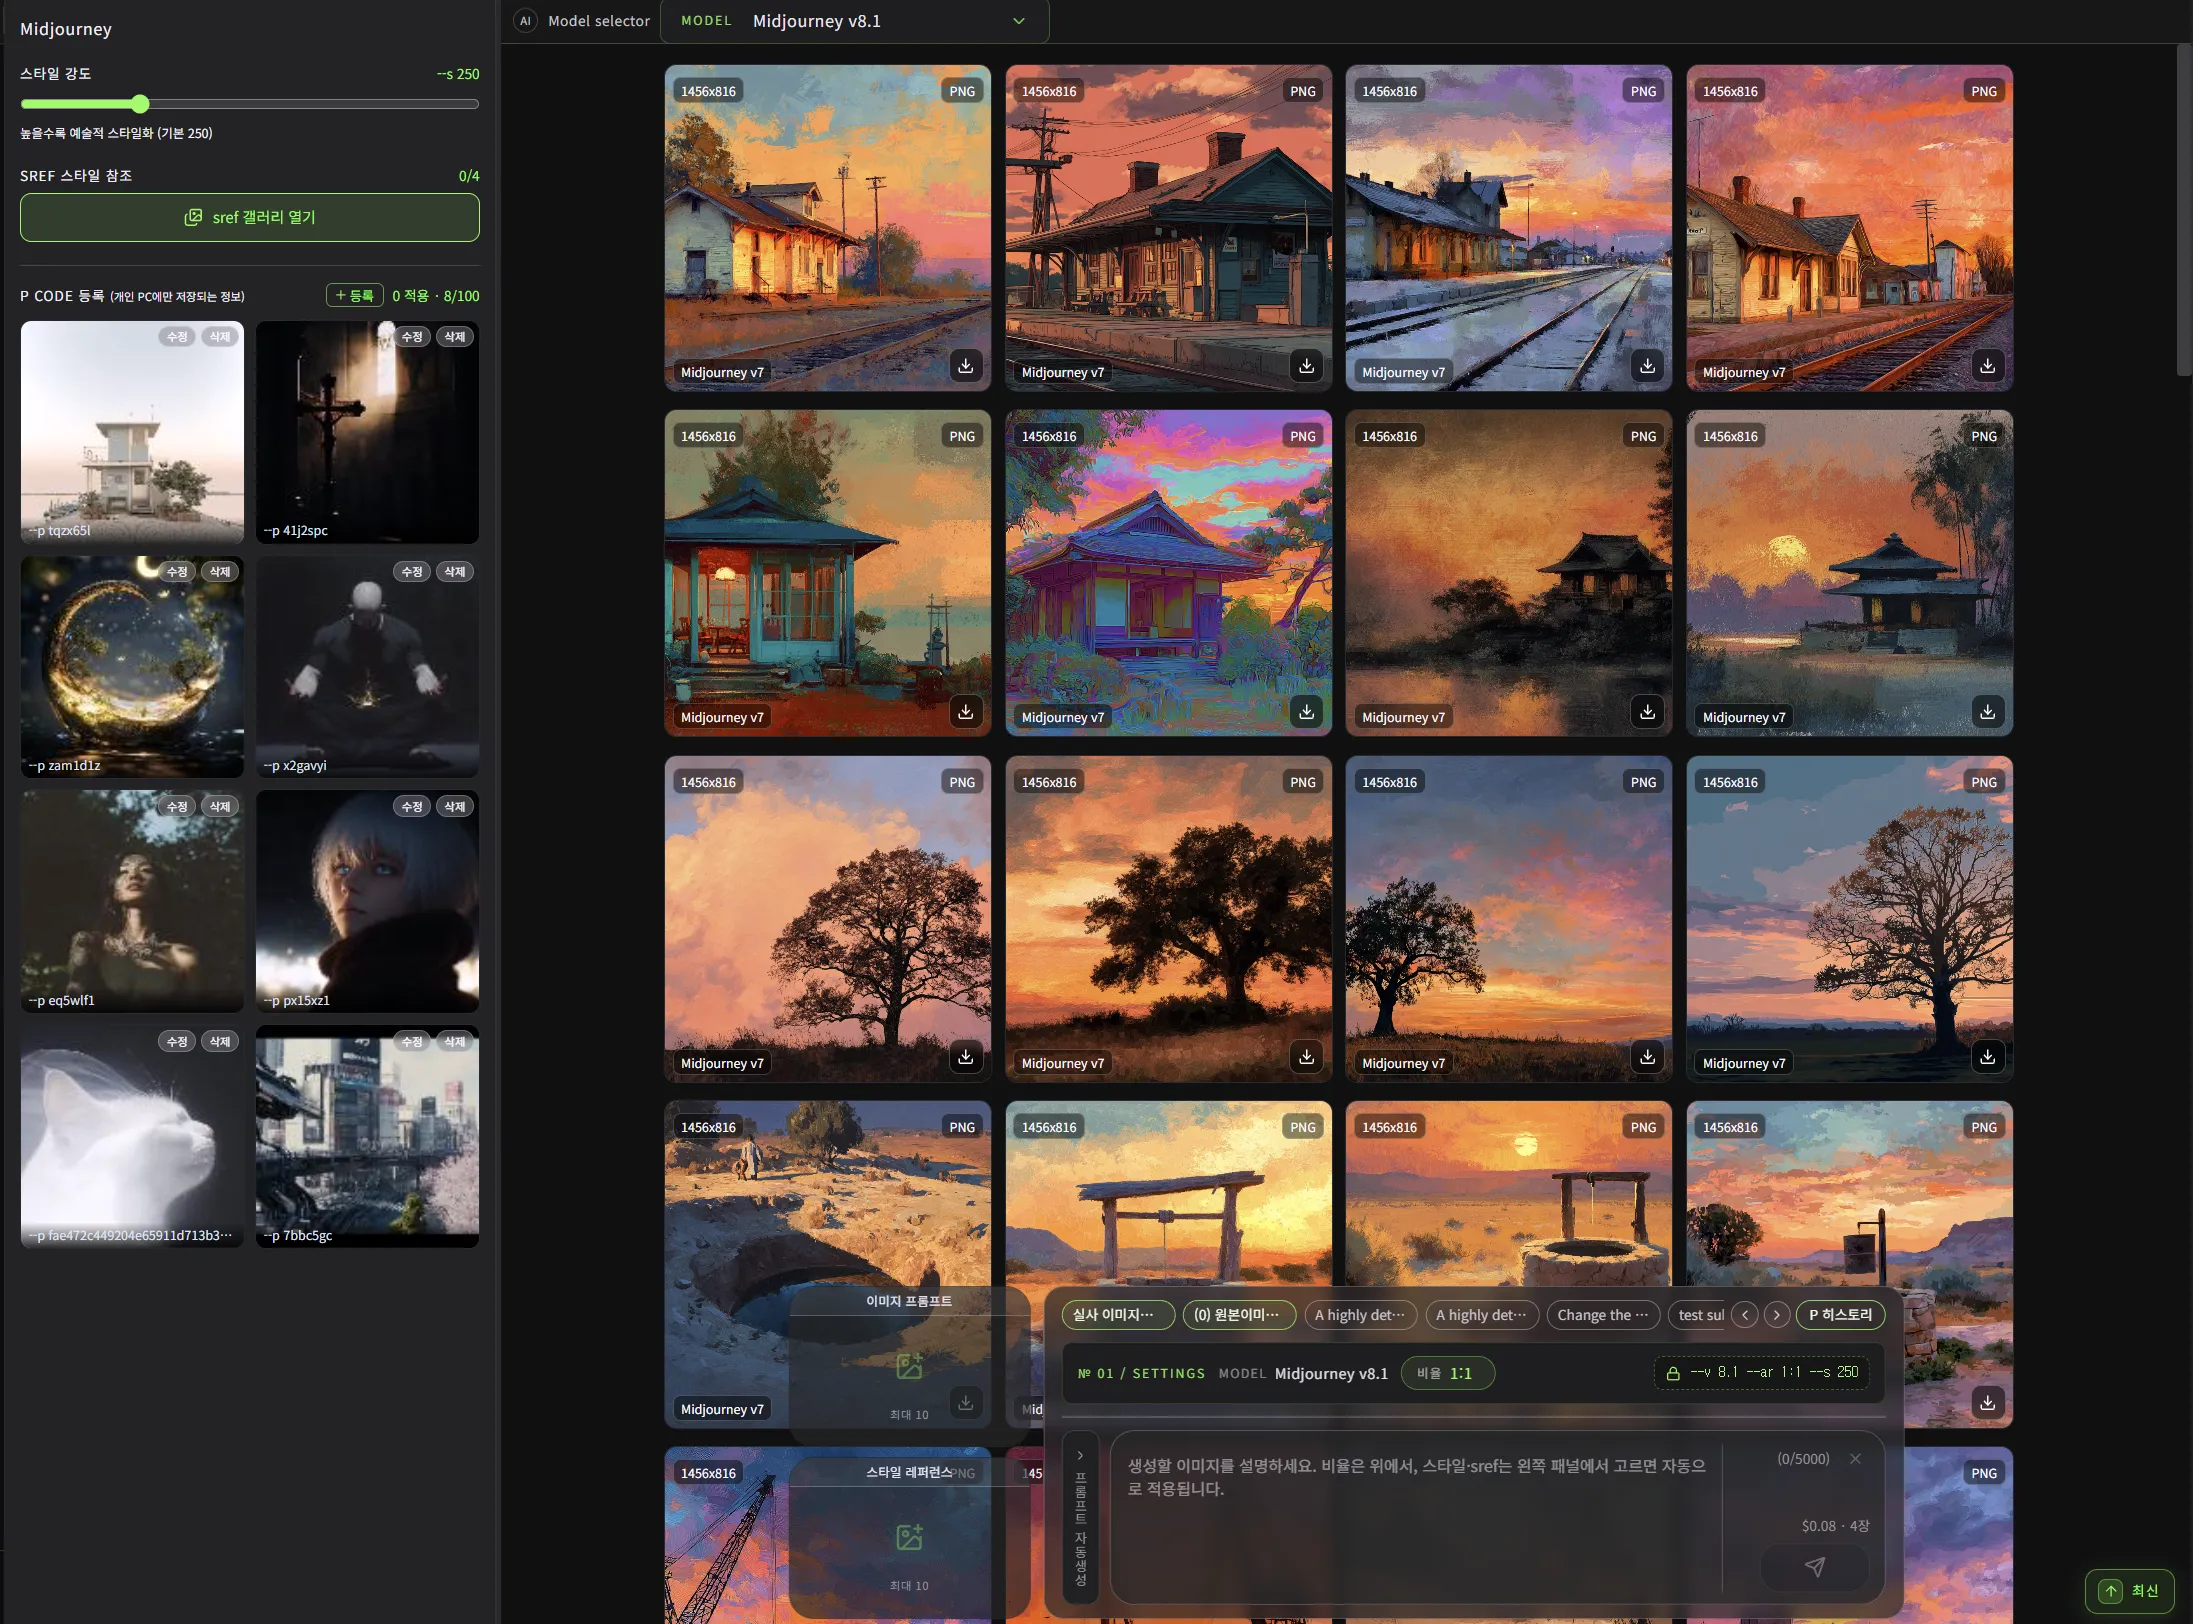
비율, 스타일 강도, 스타일 참조(sref 코드와 이미지, 가중치), 이미지 프롬프트와 가중치, 개인화 코드를 화면에서 고르면 프롬프트 플래그로 자동 조립합니다. 플래그 문법을 외울 필요가 없습니다.
약 490개의 스타일 참조를 애니·실사·기타로 분류해 갤러리로 제공합니다. 항목이 많아도 끊기지 않도록 가상 스크롤로 그립니다.
자주 쓰는 개인화(P) 코드를 썸네일과 함께 최대 100개까지 등록해 둡니다. 개인 정보에 가까운 값이라 서버가 아닌 사용자 PC에만 저장합니다.
다른 이미지 생성과 똑같이 요청 → 대기 → 결과 회수의 흐름을 탑니다. 한 번에 나오는 4장은 개별 이미지로 저장되어 각각 내려받거나 다음 워크플로우의 입력으로 쓸 수 있습니다.
07 — API Engineering
생성 모델은 공급자마다 호출 방식도, 걸리는 시간도, 실패하는 방식도 다릅니다. 이 차이를 서비스 안쪽에서 흡수해, 아티스트가 어떤 모델을 고르든 같은 방식으로 요청하고 결과를 받도록 만들었습니다.
01
공급자마다 다른 API를 하나의 작업 큐로 묶었습니다. 모든 생성 요청은 대기 → 실행 → 완료/실패의 같은 흐름을 따르고, 이미지·영상·3D를 별도 레인으로 병렬 처리해 오래 걸리는 작업이 다른 작업을 막지 않습니다.
02
완료 통지는 웹훅으로 받고 서명을 검증하며, 웹훅이 오지 않아도 폴링이 결과를 회수합니다. 같은 통지가 두 번 와도 한 번만 반영되도록 멱등성 키로 막고, 처리에 실패한 웹훅은 재시도 큐로 넘깁니다.
03
공급자별 동시 실행 한도를 두고 재배포 없이 조정합니다. 공급자가 한도 초과를 돌려주면 작업을 실패시키지 않고 다시 대기시키며, 그때의 동시 실행 수를 한동안 상한으로 삼습니다. 대기량에 따라 워커 처리량도 자동으로 조절합니다.
04
모델별·품질별 단가를 카탈로그로 관리하고, 작업을 시작할 때 비용을 잡아 두었다가 성공하면 확정, 실패하거나 시간이 초과되면 자동 환불합니다. 부서와 사용자 단위로 사용량을 볼 수 있습니다.
05
결과물은 클라우드 스토리지에 저장하고 서명된 주소로만 내려줍니다. 한 워크플로우의 결과를 다음 워크플로우의 입력으로 바로 넘길 수 있고, 과거 작업의 설정을 그대로 불러와 다시 만들 수 있습니다.
06
같은 생성 기능을 다른 팀과 서비스가 쓸 수 있도록 API로 열었습니다. API 키 인증, 생성 요청 → 상태 조회 → 파일 수신의 비동기 방식, 키별 동시 실행 제한과 호출 기록을 갖췄습니다.
공급자 API가 필요 없는 작업은 브라우저에서 직접 처리합니다. 모션 루프 영상 인코딩, 얼굴 랜드마크 추출, 3D 모델 뷰어와 포즈 편집이 여기에 해당합니다.

09 — Contact
AI Art 워크플로우에 최적화된 개발자

